如今,嵌入式设备价格便宜,并且有与真不错规格多种选择。五年前,例如,它是不可想象找到一个四核主板不到30 $。不过,虽然嵌入式硬件市场的不断增长,从软件的角度来看,一些挑战仍然存在。
在物联网(IOT)环境中,设备彼此交互网络,连接是存在以服务为主要目的,一个要求:数据传输。在某些情况下,这个数据包含旨在调用远程功能在对等设备,或提供从他人内的传感器,服务,和指标即将到来的信息的某些指令。因为数据通常来自不同的来源,它可能会派上不同的格式,所以收集这些信息需要特殊处理。一种常见的方法是通过一个统一日志记录层的实现; 请记住,日志记录不再局限于数据在文件中,而是对数据流。
当收集到这些数据,这是非常有用的,它存储在数据库中的简单或第三方服务。如果我们的目标是进行实时查询,这将是巨大的,这些记录插入到Elasticsearch实例或类似的解决方案。因为我们正在处理的有限的环境,不是所有可用的工具都适合以帮助这个任务。
本文介绍了一个建立来解决数据收集,统一和交付相关的常见问题嵌入式Linux(和一般的物联网环境)的专用工具:流利位。
流利的位
流利位原本是嵌入式Linux开发的开源数据收集工具。它的目的是解决与数据相关联的,从收集到的分布的所有问题。它的建成在C和提供以下功能:
小蕊
输入/输出插件
事件驱动(异步I / O网络操作)
与MsgPack内部数据序列化
内置指标
SSL / TLS支持
流利位可以处理在不同的模式的数据收集,并且它可以侦听在网络上(本地或远程),从正在运行的系统收集预定的指标或简单地被用来作为由任何程序库,希望刷新数据到数据库或第三三方服务。
对于流利位,每一个数据源是通过一个处理输入插件,并交付目标由处理输出插件。下表描述了收集和交付可用的选项:
名称 | 类型 | 描述 |
中央处理器 | 输入 | 收集CPU使用情况的指标,在全局模式下,每个核心。 |
纪念品 | 输入 | 计算内存状态:总量与可用。 |
kmsg | 输入 | 读取直接从内核日志缓冲区的日志信息。 |
的XBee | 输入 | 从连接的设备的XBee接收消息。 |
串行 | 输入 | 获得从串行接口的消息。 |
标准输入 | 输入 | 阅读从标准输入信息。 |
MQTT | 输入 | 侦听MQTT消息通过TCP(行为作为MQTT服务器)。 |
ES | 产量 | 刷新记录到Elasticsearch服务器。 |
fluentd | 产量 | 刷新记录到Fluentd数据采集器/聚合器实例。 |
TD | 产量 | 刷新记录,以宝数据云服务(大数据)。 |
标准输出 | 产量 | 刷新记录到标准输出(调试)。 |
入门
出于演示的目的,我将展示如何收集从Linux嵌入式设备CPU的一些指标(如树莓派或通用Linux主机),并插入这些记录到一个非常基本的,动手的例子Elasticsearch服务。最后,我将使用Kibana表现出一定的可视化。
安装流利位
我会假设你有一个树莓派运行设备Raspbian ; 否则,正常的Linux主机使用的Debian或Ubuntu的是好的。安装软件包分发之前,请务必安装APT关键系统:
$ wget的-qO - http://apt.fluentbit.io/fluentbit.key | sudo易于键添加-
现在,根据您的具体分布,添加正确的储存库进入到你的包的列表。
树莓派/ Raspbian 8(杰西):
$ sudo的苏-c“回声的deb http://apt.fluentbit.io/raspbian杰西主要>> /etc/apt/sources.list中”
Debian的8(杰西):
$ sudo的苏-c“回声的deb http://apt.fluentbit.io/debian 杰西主要>> /etc/apt/sources.list中“
Ubuntu的15.10(威利狼人):
$ sudo的苏-c“回声的deb http://apt.fluentbit.io/ubuntu老谋深算的主要>> /etc/apt/sources.list中“
最后,请更新你的本地库安装流利位:
$ sudo易于得到更新
$ sudo易于得到安装fluentbit
安装Elasticsearch和Kibana
下面的步骤给你如何安装Elasticsearch和Kibana组件一些提示,注意,这里提到的步骤只是一个参考,我鼓励你仔细检查贴的链接。让我们先从Elasticsearch:
请按照所选择的包安装说明。
一旦安装完毕,请确保以下卷曲测试命令得到了一些结果预期:
$卷曲-X GET 的http://本地主机:9200 /
 {
  “名”:“抖抖人”,
  “CLUSTER_NAME”:“elasticsearch”,
  “ 版本”:{
    “数字”:“2.1.1”,
    “build_hash”: “40e2c53a6b6c2972b3d13846e450e66f4375bd71”,
    “build_timestamp”:“2015-12-15T13:05:55Z”,
    “build_snapshot”:假的,
    “lucene_version”:“5.3.1”
  },
  “ 口号”:“你知道,搜索”
}
在这一点上,Elasticsearch启动并运行,所以我们可以继续安装Kibana(数据可视化工具):
获得从最新版本的 https://www.elastic.co/downloads/kibana。
下载解压压缩包,在一个单独的终端后,按照上面的链接指定运行服务。
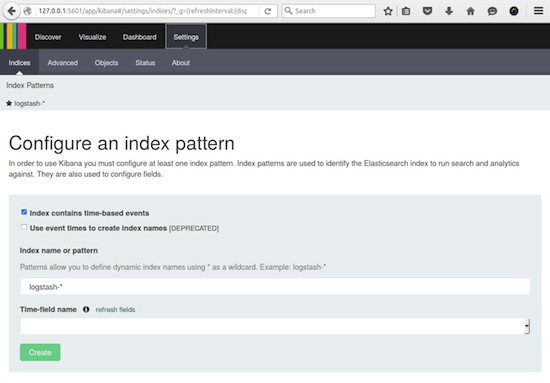
如果Kibana服务正在运行,可以通过地址访问仪表板 http://127.0.0.1:5601,你应该得到的内容与此类似:
 在下面的部分,我将展示如何收集一些CPU指标为例流利位,并开始插入记录Elasticsearch。
流利位/ CPU度量
现在,我们的所有组件都是在地方,我们可以开始获得从那里流利位已被安装在主板或主机指标。如前面提到的,流利位需要知道应该使用的输入和输出的插件。这些可以通过命令行来指定,例如:
$流利位-i输入输出-o
对于这个用例中,我们将使用收集的CPU利用率指标CPU的输入插件,并通过了一个Elasticsearch实例的数据刷新ES插件。除了 它的名字,它也需要一些额外的参数:主机名(或IP),TCP端口,指数和类型:
$流利位-i CPU -o ES://主机名:TCP_PORT / INDEX / TYPE
理想情况下,你会从你的树莓派运行流利位。请务必使用正确的主机名或IP地址来到达网络中的服务器Elasticsearch; 否则,您可以使用回送地址127.0.0.1如果所有组件都在同一台机器。
假设我们Elasticsearch服务器位于TCP地址192.168.1.15,我们将开始插入CPU指标使用下面的命令:
$流利位-i CPU -o ES://192.168.1.15:9200 / fluentbit / CPU -V
该-V参数打印详细消息。离开该终端上运行的工具将收集指标每一秒,并将它们刷新到Elasticsearch服务器每五秒钟。
可视化与Kibana
虽然流利位记录插入Elasticsearch,我们将准备Kibana可视化的信息。执行从那里Elasticsearch和Kibana运行的主机下面的命令:
$ wget的http://fluentbit.io/kibana/fluentbit.mapping.json
 $ wget的http://fluentbit.io/kibana/fluentbit.cpu.json
现在,为了创造良好的位,它的CPU数据的默认映射,这样做:
$卷曲-XPUT 的http://本地主机:9200 / fluentbit -d @ fluentbit.mapping.json
再次,通过地址打开Kibana仪表板 http://127.0.0.1:5601,进入设置在顶部菜单,并准备配置索引图案如下图所示: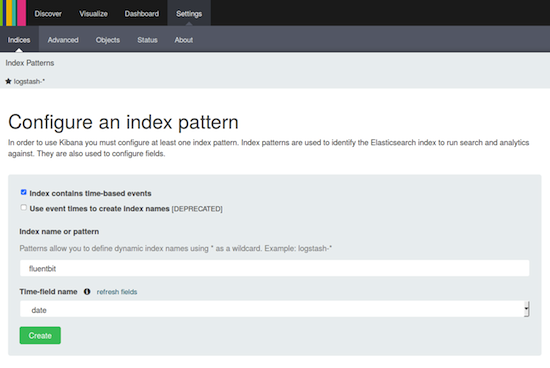 请注意,指数包含基于时间的事件必须进行检查,索引名是fluentbit和时间字段名自动填充日期。然后,点击创建按钮。
可视化对象
接下来的最后一步是加载预定义的可视化对象。进入设置,然后单击对象选项,然后单击导入按钮并选择fluentbit.cpu.json最近下载的文件。
现在导航到仪表板顶部的菜单,点击+按钮,并选择新的流利位- CPU的可视化对象。添加后,将开始显示CPU的指标,如下所示: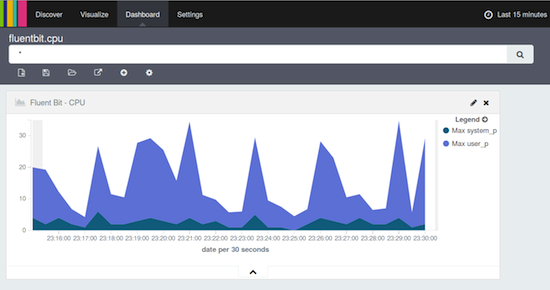
上述图形显示系统已经多少CPU分别花费在内核和用户空间。
更多关于流利位
在这篇文章中,我已经证明的能力,只是一小部分流利位。如果您是嵌入式Linux编写一些自定义的C程序,你可以使用它作为一个不可知论者日志库,并且很会照顾数据打包和路由。如果你关心安全性,TLS可以毫不费力所有的网络插件启用。
随时检查源代码在我们github.com/fluent/fluent-bit库,在那里你会找到更多的资源进行包装,例如,单元测试用例,并食谱Yocto项目。您还可以了解更多的官方文档。
数以千计的日常用户收集数十亿条记录与Fluentd,现在宝数据正在采取这方面的经验,以嵌入式Linux和物联网与世界FluentBit。
社区公告
流利位是金Fluentd项目的生态系统,我们将在参演Scale14x事件。加入我们在我们上周六,1月23日会议或刚刚来我们的展台流利打招呼。如果你是这些工具的一个活跃的用户,执行ping我们@fluentbit,因为我们将有免费的贴纸和T恤!
 爱德华多·席尔瓦是宝数据公司的首席开源开发目前,它导致使日志生态系统的嵌入式和云服务之间更友好的努力。他还指示猴子项目组织是开放源码项目猴HTTP Server和杜达I / O后面。
注释